PgBouncer - помогает, но не решает все проблемы
PgBouncer используют, чтобы сократить дорогие коннекты к postgres:
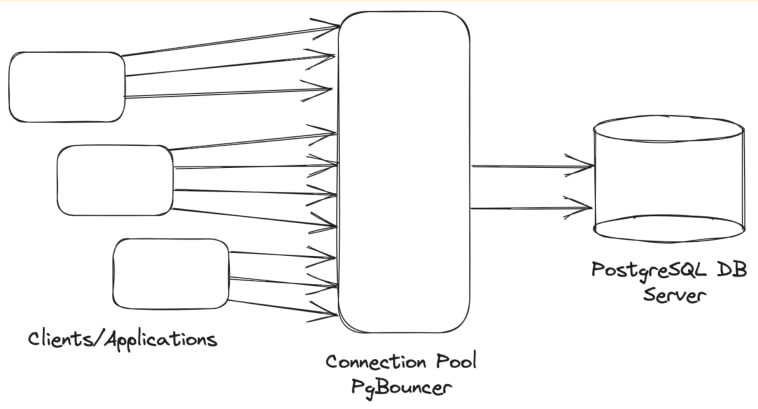
Если Client (Application) запускается Х раз в секунду, он делает Х подключений к PgBouncer, что в итоге превращается например в 2 запроса к PosgreSQL DB Server.
Например в php-pfm в среднем прилетает 5 запросов в секунду:
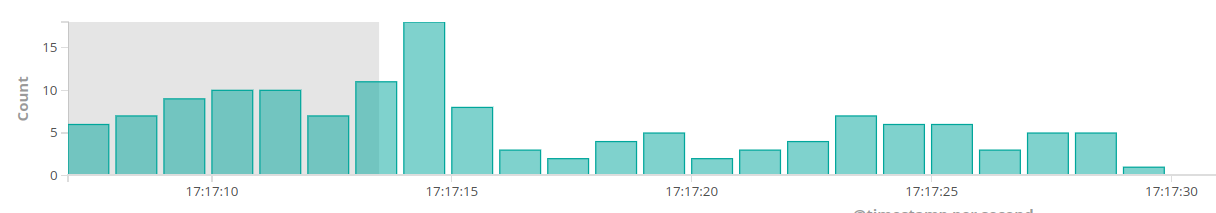
Таким образом мы получим 5 подключений к PgBouncer.
Но, если каждый из 5 запросов будет работать 2 секунды, то в PgBouncer мы увидим 10 подключений в Connection Pool.
Если в php-pfm прилетит 65 запросов, каждый из которых будет работать 2 секунды, то мы получим 130 подключений в Connection Pool и тогда в PgBouncer сработает настройка:
default_pool_size (для всех user/database пар он одинаковый) = 128 подключений
По идее все что свыше 128 подключений PgBouncer отбросит сразу, но практика показала, что он все же принимал подключения и переводил их в статус idle (простаивающие, в прочем как и остальные, которые были созданы в рамках ограничения в 128 штук, но которые PgBouncer не мог обслужить потому что, PosgreSQL не успевал).
В теории, если в pgbouncer увеличить pool_size для "user/database пары", то это поможет PgBouncer-у держать больше idle подключений, что в свою очередь скажется на возможности держать рабочими еще большее количество php-fpm процессов, что в свою очередь поможет породить еще больше k8s-подов для php-pfm (но у нас в k8s стоит настройка максимума: 10 подов и это хорошо, а то бы все ресурсы бы утилизировались и ущерб был бы катастрофическим).
Итог:
- если тормозит база, то будет увеличиваться количество php-pfm процессов, которые не должны работать долго, их надо прибивать
- если будет большая нагрузка, то поставить таймаут на работу php-fpm процесса будет плохой стратегией, ведь php-pfm pool может вырасти в короткий срок и таймаут не спасет, поэтому хорошей стратегией будет Circuit Breaker Pattern
- но, если реализовать стратегию Circuit Breaker Pattern то делать ее нужно с постепенным понижением/увеличением трафика
k8s
По идее k8s может реализовать стратегию Circuit Breaker Pattern самостоятельно с помощью readiness probe, но:
- k8s дергает readiness probe, которая делает легкий запрос в PgBouncer и подвисает на Х секунд
- k8s ждет 1 секунду и readiness probe завершится падением
- k8s снимает трафик с pod-a
- k8s еще 30 раз (по-умолчанию) дергает readiness probe, все из которых завершаются падением и переходит к шагу 1 (цикл)
Когда шаг 3 выполнен, но запросы в приложение идут, k8s создает новые pod-ы до тех пор, пока не будет достигнуть максимальный лимит создания pod-ов в k8s.
Когда все поды в статусе "проверка readiness probe" (поды без трафика), на каком-то поде может пройти readiness probe и:
- весь трафик направляется на эту бедную поду
- в результате бедная пода почти мгновенно расходует все свои ресурсы (процессор, озу)
- в результате бедная пода почти мгновенно сильно нагружает сторонние приложения (например базу)
- в результате readiness probe на этой бедной поде перестает быть успешной
- на поду перестает поступать трафик
Дальше все выше указанные 5 пунктов могут повториться но уже с другой подой, но это уже не важно, ведь если приложение или инфраструктура не может выдержать такую большую почти мгновенную нагрузку, то тут может помочь только постепенное понижение/увеличение трафика, но k8s так делать не умеет.
Получается k8s не панацея и нужно учить приложение анализировать свой состояние и на основе этих показателей постепенно уменьшать/увеличивать трафик (таким образом сразу отклоняя запросы, которые приложение не может обслужить).
haproxy
Если перед k8s поставить haproxy, умеющий увеличивать трафик медленно (см. настройку slowstart), то достигнем желаемого.
Однако запросы внутри k8s не ходят через внешний haproxy, трафик внутри k8s ходит от к сервиса к сервису напрямую, а значит haproxy не поможет.
k8s как Circuit Breaker
Предположим, мы имеем:
- 10 подов приложения
- каждому поду выделено 1 Гб ОЗУ и 1 ядро процессора
- итого в сумме выделено 10 Гб ОЗУ и 10 ядер
Давайте превратим 10 подов в:
- 100 подов приложения
- каждому поду выделено 0.1 Гб ОЗУ и 0.1 ядро процессора
- итого в сумме выделено 10 Гб ОЗУ и 10 ядер (столько же)
Теперь k8s.sheduler будет реализовывать Circuit Breaker распределяя 100% трафика на 100 подов (каждому по 1% трафика).
Вуаля k8s.sheduler будет делать readiness probe на каждом поде и будет постепенно увеличивать трафик (и уменьшать тоже).
Да, этот подход спасет от ситуации, когда большое количество трафика пойдет на один под, ведь один маленький под сможет обслужить только небольшое количество трафика исходя из маленького количества ресурсов (таким образом база не будет нагружена большим количеством запросов в следствии небольшого количества запросов к поду).
Минусы:
- readiness probe дергает бд, а значит чем больше подов в деле, тем сильнее загружена база данных (незначительно)
- каждый под имеет php-fpm мастер процесс, а ведь он тоже отъедает ресурсы (незначительно)
- каждый под имеет несколько сайд-кар контейнеров, они тоже используют ресурсы (неприятно, но жить можно)
Комментарии
Комментариев пока нет.