MapReduce
Идеология - выполнять какую-либо обработку данных как-можно ближе к данным (избегая оверхеда между клиентом и сервером) + иногда в реалтайме. Из мира реляционных бд это напоминает выполнение SQL-инструкции в бд, а не вытаскивание данных из бд и их обработка в приложении.
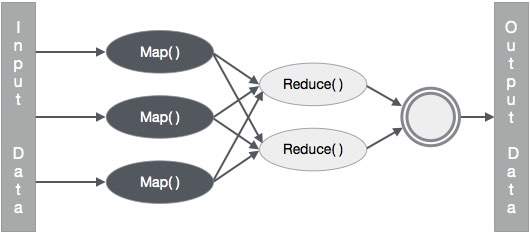
Работа MapReduce состоит из двух шагов: Map и Reduce, названных так по аналогии с одноименными функциями высшего порядка:
- map - применяет какую-либо функцию к каждому элементу списка
- reduce - производит преобразование структуры данных к единственному атомарному значению
Еще одним преимущество MapReduce заключается в том, что он позволяет распределенно производить операции обработки и свертки.
MapReduce — это инфраструктура, которая используется для написания приложений для надежной обработки огромных объемов данных на больших кластерах аппаратного оборудования.
Алгоритм MapReduce — реализация Hadoop
Обычно парадигма MapReduce основана на отправке программ сокращения карт на компьютерах, где хранятся фактические данные.
- Во время задания MapReduce Hadoop отправляет задачи Map и Reduce на соответствующие серверы в кластере.
- Каркас управляет всеми деталями передачи данных, такими как выдача задач, проверка выполнения задач и копирование данных вокруг кластера между узлами.
- Большая часть вычислений происходит на узлах с данными на локальных дисках, что снижает сетевой трафик.
- После выполнения заданной задачи кластер собирает и сокращает данные, чтобы сформировать соответствующий результат, и отправляет их обратно на сервер Hadoop.
Комментарии
Комментариев пока нет.