SLI - SLO - SLA
Цель - создать инструментом для принятия решений (реализовывать новый функционал или устранять проблемы).
Сначала теория, а ниже сухая практика на примере, а для начала терминология.
- SLI (service level indicators) - индикаторы/показатели работы сервиса (бизнес называет это уровнем качества обслуживания), значения SLI могут отличаться от значений SLO
- SLO (service level objectives) - целевые показатели индикаторов (значения индикаторов, которые нас устроят)
- SLA (service level agreements) - это SLO, нарушение которого может привести к судебному иску о нарушении контракта
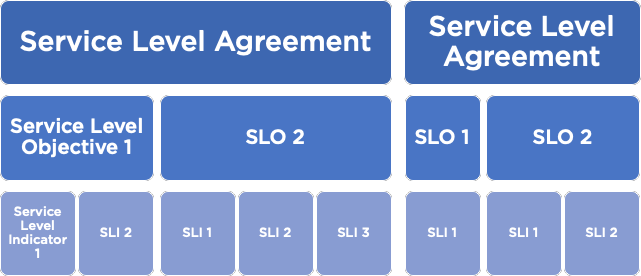
Пример:
| SLI | SLO | Как рассчитывается | В течении |
| TTLB < 300 мс | 99.9% | (100 * "кол-во запросов с TTLB >300 мс") / "кол-во всех запросов" | 5 минут |
| доступность | 99.9% | (100 * "кол-во неуспешных запросов") / "кол-во всех запросов " | 5 минут |
| кол-во todo в коде | 0.01% | (100 * кол-во todo в коде репозитория) / кол-во строк кода репозитория | вообще |
| ошибки | 0.01% | (100 * "кол-во ошибок") / "кол-во всех запросов" | 5 минут |
Фактически может получиться так:
| SLI (индикатор) | SLI (реальное значение) | SLO (ожидаемое значение) |
| TTLB < 300 мс | 95.3% | 99.9% |
| доступность | 99.8% | 99.9% |
| кол-во todo в коде | 0.05% | 0.01% |
| ошибки | 0.01% | 0.01% |
Бюджет ошибок
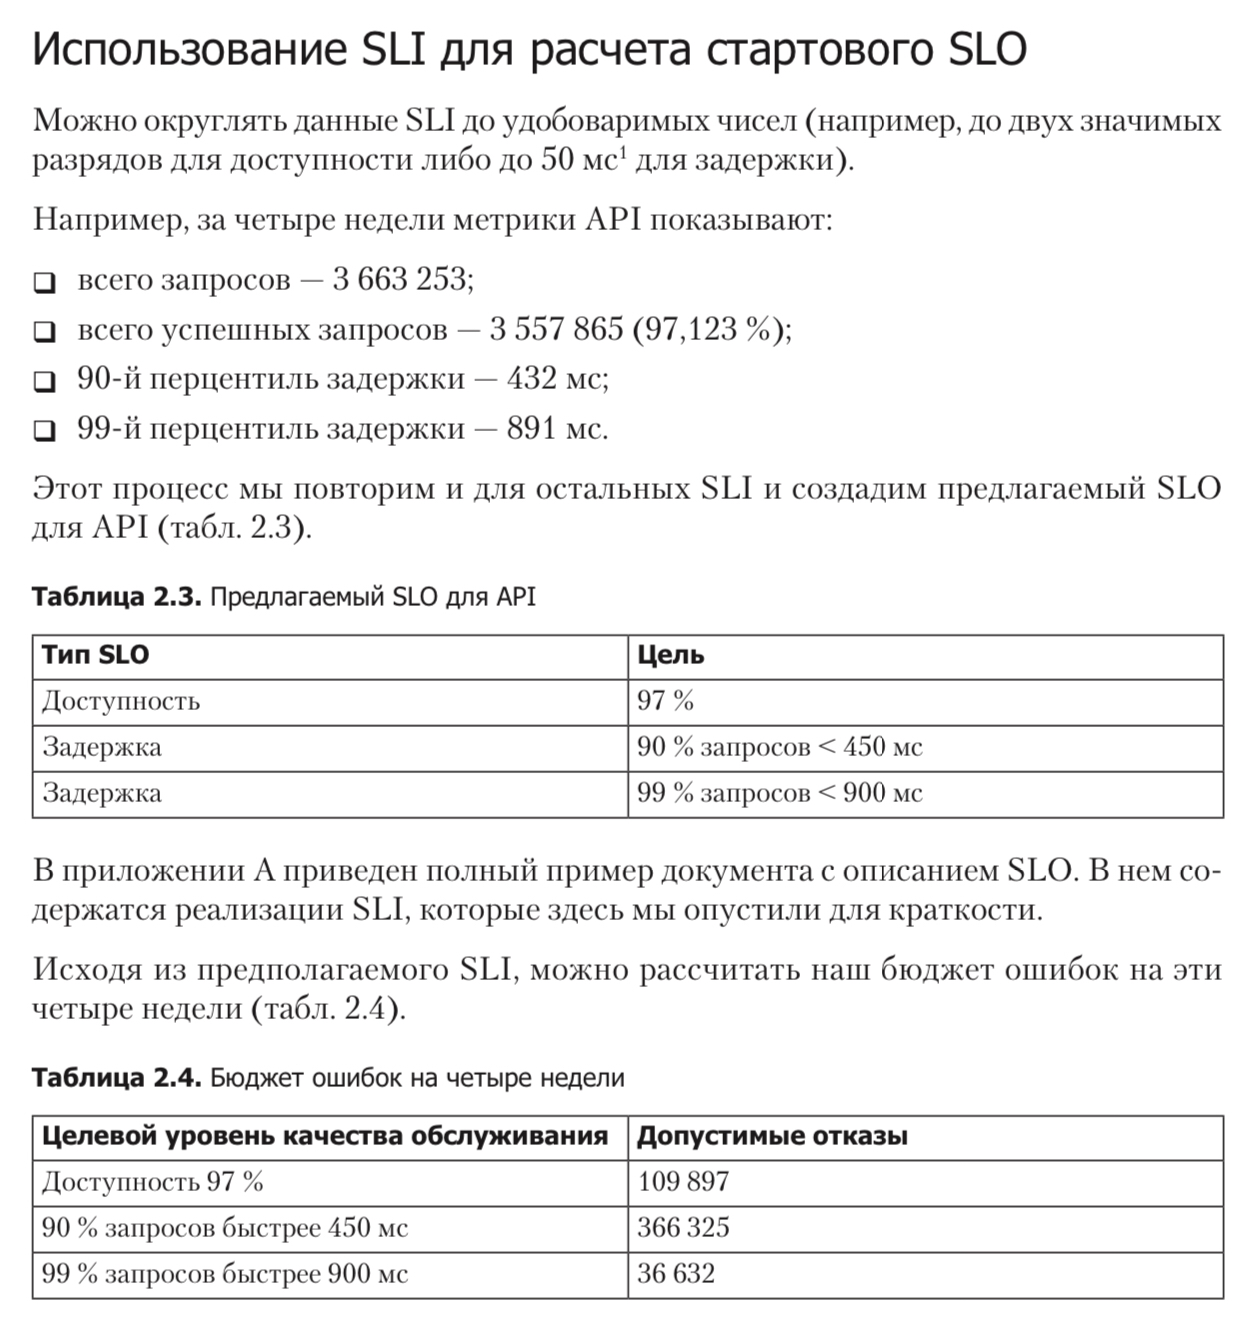
Продукт должен иметь установленный целевой показатель доступности. Как только этот показатель определен, допустимый суммарный уровень ошибок будет равен единице минус запланированный показатель доступности. Сервис, который доступен в 99,99 % случаев, недоступен в 0,01 % случаев. Этот допустимый уровень недоступности и есть не что иное, как допустимый суммарный уровень ошибок (бюджет ошибок). Мы можем тратить этот «бюджет» на все, что сочтем нужным, пока не выходим за его пределы.
Применение принципа допустимого суммарного уровня ошибок разрешает противоречие интересов между командами разработчиков и SR-инженеров. Цель SR-инженеров уже не сводится к обеспечению отсутствия сбоев; вместо этого обе команды стремятся расходовать предоставленный бюджет ошибок так, чтобы максимально быстро внедрить новый функционал и выпустить продукт. Это и есть главное отличие. Сбои и дефекты (баги) больше не считаются чем-то «плохим» — это ожидаемая часть процесса внедрения новшеств. Команды разработчиков и SR-инженеров теперь не боятся их, а управляют ими.
Например, пусть согласно SLO сервиса он должен успешно обслуживать 99,999 % всех запросов за квартал. Это означает, что лимит времени недоступности сервиса в данном квартале равен 0,001 %. Если из-за какой-либо проблемы ошибки будут возникать при обработке 0,0002 % ожидаемых запросов, будет считаться, что эта проблема поглощает 20 % квартального бюджета ошибок.
В итоге мы стараемся определить показатели уровня качества обслуживания (service level indicators, SLIs), а также целевые показатели (objectives, SLOs) и соглашения (agreements, SLAs).
Для большинства сервисов ключевым SLI является время отклика, или латентность запросов, — время, которое требуется для того, чтобы вернуть ответ на запрос. В качестве SLI могут также использоваться уровень (или частота) ошибок, который часто выражается как процент от общего количества запросов, и пропускная способность системы, чаще всего измеряемая в запросах в секунду. Результаты измерений обычно агрегируются: например, первичные данные, собранные в пределах «окна измерения», затем усредняются, приводятся к процентному уровню, или к процентилю.
SLO — это целевой уровень качества обслуживания: целевое значение или диапазон значений, измеряемые с помощью SLI. Естественная структура SLO выглядит как SLI ≤ целевое значение или нижняя граница ≤ SLI ≤ верхняя граница. Например, мы можем решить, что сервис Shakespeare будет возвращать результат «быстро», и укажем, что среднее время отклика должно быть равно 100 миллисекундам или меньше.
Простой способ понять разницу между SLO и SLA заключается в том, чтобы задать себе вопрос: «Что случится, если требования SLO не соблюдаются?» Если явных последствий не существует, то, скорее всего, перед вами только SLO. Реальное нарушение SLA может привести к судебному иску о нарушении контракта.
Чтобы привить подход к обеспечению надежности сайтов, основанный на соблюдении бюджета ошибок, необходимо достичь состояния, при котором выполняются следующие условия.
Существуют целевые уровни качества обслуживания, одобренные всеми лицами, принимающими решения в организации, как подходящие для данного продукта.
- Люди, отвечающие за то, чтобы уровень предоставления сервиса соответствовал SLO, договорились, что данный SLO реально обеспечивать в нормальных обстоятельствах.
- Организация нацелена на использование бюджета ошибок для принятия решений и расстановки приоритетов. Эта готовность формализована в виде стратегии бюджета ошибок.
- Определен процесс совершенствования SLO.
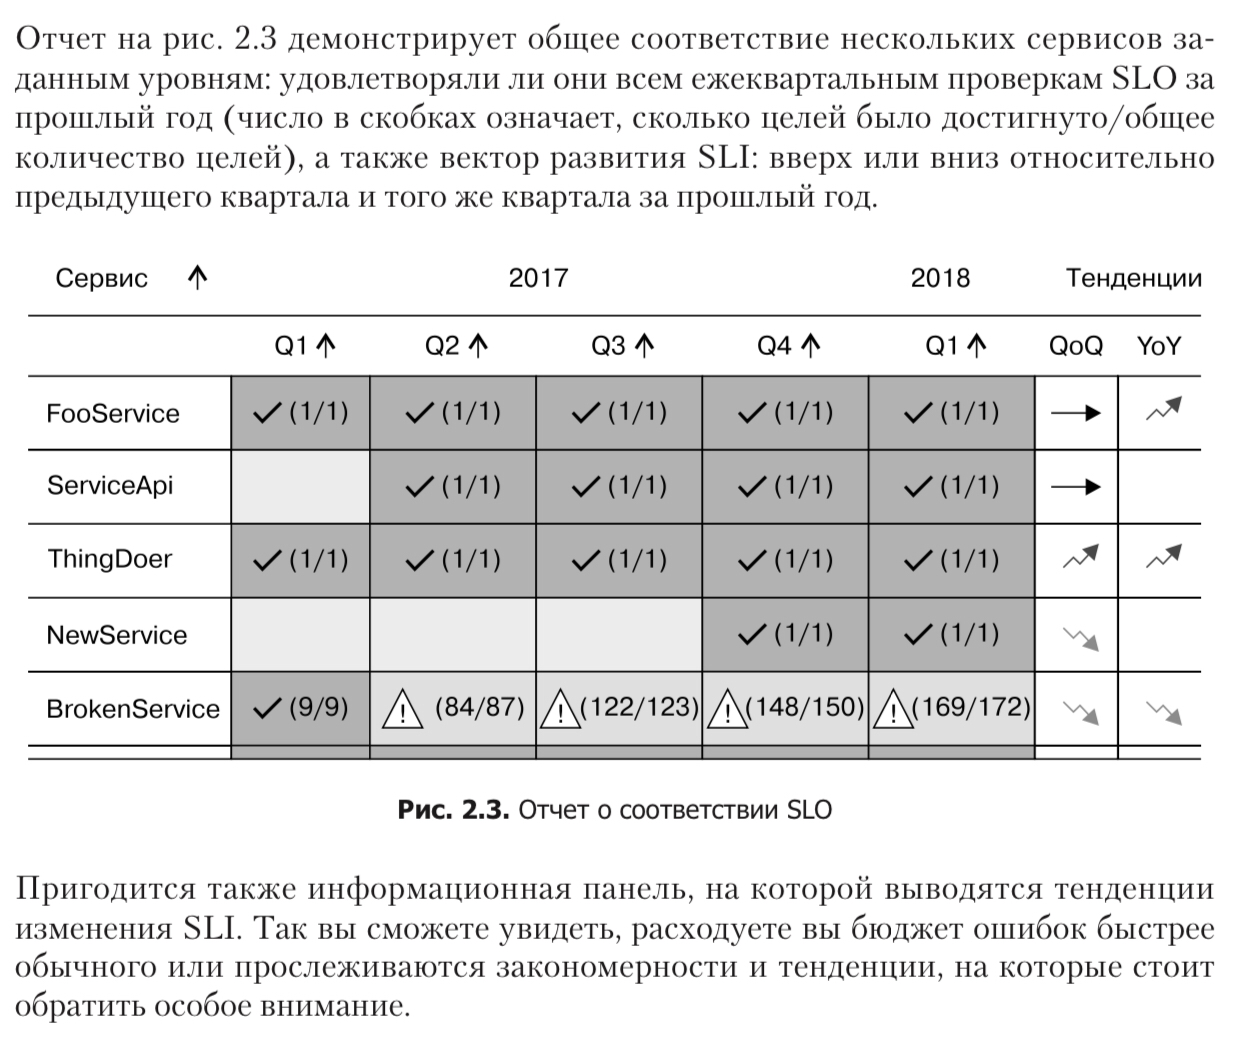
В противном случае вы не сможете организовать обеспечение надежности на основе бюджета ошибок. Соответствие SLO станет просто очередным КИП (ключевым индикатором производительности) или отчетным параметром, а не инструментом для принятия решений.
После того как вы установите уровень SLO ниже 100 %, соблюдение этого уровня нужно поручить кому-то в организации, кто будет уполномочен искать компромиссы между скоростью разработки новых возможностей и обеспечением их надежности. В небольших организациях этим может заниматься CTO (главный технический директор), в более крупных — как правило, владелец продукта (или менеджер по продукту).
Расчет доступности
С математической точки зрения доступность операции равна произведению доступности компонентов в ней участвующих. И не может превышать доступность каждого из её компонентов, то есть в данном случае, если доступность сервиса B равна 50%, то доступность сценария, в котором участвует сервис B не может быть более 50%. Даже, если доступность одного компонента 99,5%, что довольно высоко, то доступность операции будет ниже, а именно 98,5%:
99,5%*99,5%*99,5%=98,5%
С ростом числа компонентов, доступность будет снижаться:
99,5%*99,5%*99,5%*99,5%*99,5%=97,5%
Источники: 1
Комментарии
Комментариев пока нет.