Unicode последовательность
Введение.
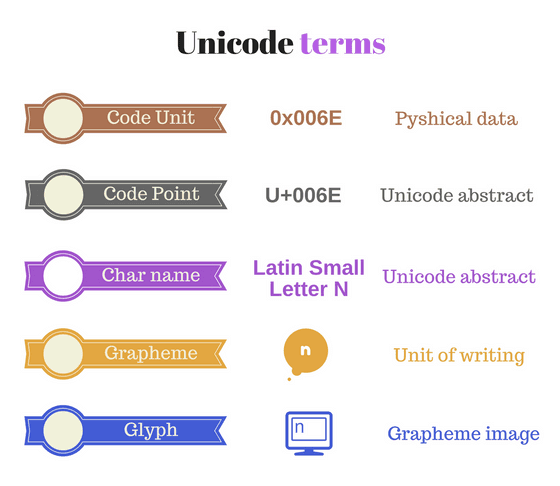
Кодовая точка — это число, присвоенное одному символу, например вот кодовая точка: U+2603
Кодовые точки — это числа в диапазоне от U+0000 до U+10FFFF.
Не все кодовые точки могут отображаться (про такие точки говорят, что они не имеют связанных символов).
Кодовая точка U+2603 имеет отображение и соответствует символу с именем SNOWMAN (отображается как ☃)
Всего доступно 1 114 112 кодовых точек (в диапазоне от U+0000 до U+10FFFF), но только 144 697 из них (на сентябрь 2021 года) имеют связанные символы (имеют отображения).
Весь набор кодовых точек Unicode разбит на 17 плоскостей (последовательности).
BMP (Basic Multilingual Plane) — основная многоязычная плоскость (плоскость 0 содержит точки от U+0000 до U+FFFF) и как видно, могут содержать до 4 шестнадцатеричных цифр.
Примеры: ■ — U+25A0, BLACK SQUARE / ☂ — U+2602, UMBRELLA
Астральные плоскости (дополнительные, astral/supplementary) - 16 плоскостей после BMP (плоскость 1-16).
Кодовые точки в астральных плоскостях, называются астральными кодовыми точками. Они находятся в диапазоне от U+10000 до U+10FFFF.
Астральная кодовая точка может содержать 5 или 6 цифр в шестнадцатеричном формате: U+dddddd или U+ddddddd.
Пример: 𝄞 — это U+1D11E, MUSICAL SYMBOL G CLEF
Графема — это то, как пользователь представляет символ. Реальное изображение графемы, отображаемое на экране, называется глифом (glyph).
Бывают случаи, когда графема содержит последовательность символов.
Например, å — это атомарная графема (atomic grapheme) в датской системе письма. Она передается с помощью LATIN SMALL LETTER A U+0061 (отображается как a) в сочетании со специальным символом U+030A, COMBINING RING ABOVE (отображается как ◌̊).
U+030A изменяет предшествующий символ и называется комбинирующим знаком (combining mark).
console.log('\u0061\u030A'); // => 'å'
console.log('\u0061');       // => 'a'
Закрепим знания:
Эскейп-последовательности
Эскейп-последовательность Unicode преобразуют один символ в формат 4-значного шестнадцатеричного кода, например \uXXXX. Например, «A» станет «\u0041».
В DenCode, помимо формата \uXXXX, также поддерживаются следующие форматы обозначений.
| Формат | Результат преобразования «ABC» | Описание / Язык программирования |
|---|---|---|
| \uXXXX | \u0041\u0042\u0043 | Общие эскейп-последовательность Unicode |
| \u{X} | \u{41}\u{42}\u{43} | Lua |
| \x{X} | \x{41}\x{42}\x{43} | Perl |
| \X | \41\42\43 | CSS |
| &#xX; | ABC | HTML, XML |
| %uXXXX | %u0041%u0042%u0043 | Процентное кодирование (Нестандартный) |
| U+XXXX | U+0041 U+0042 U+0043 | Стандартная запись Unicode для кодовых точек (разделенные пробелами) |
| 0xX | 0x41 0x42 0x43 | Шестнадцатеричная запись кодовых точек (разделенные пробелами) |
Некоторые из этих форматов упоминаются в RFC 5137 (ASCII Escaping of Unicode Characters) как BEST CURRENT PRACTICE, но не существует международного стандарта и т.д.
Формат %uXXXX поддерживается Microsoft IIS, но является нестандартным. Его можно закодировать в формате %u с помощью System.Web.HttpUtility.UrlEncodeUnicode в C#, но этот метод устарел с версии .NET Framework 4.5.
Обратите внимание, что в формате \X пробел рассматривается как разделитель и игнорируется при декодировании, как указано в CSS. В форматах U+XXXX и 0xX при кодировании каждый символ отделяется одним пробелом, а при декодировании, как и в формате \X, последующий подряд один пробел игнорируется.
Экранирование по имени Unicode
В качестве управляющих последовательностей Unicode также поддерживается экранирование по имени Unicode.
| Формат | Результат преобразования «A» | Описание / Язык программирования |
|---|---|---|
| \N{name} | \N{LATIN CAPITAL LETTER A} | C++23, Python, Perl |
Имена Unicode можно найти в Names List Charts - Unicode или NamesList.txt - Unicode.
Символы Unicode, отличные от BMP, в эскейп-последовательность Unicode
Для символов Unicode, не относящихся к BMP, кодовые точки не умещаются в четыре цифры, поэтому они выражаются в следующей форме обозначения для каждого языка программирования.
Результат преобразования «😀» (U+01F600), который является символом Unicode, отличным от BMP, выглядит следующим образом.
| Формат | Результат преобразования «😀» (U+01F600) | Язык программирования |
|---|---|---|
| \uXXXX | \uD83D\uDE00 | Java, Kotlin, Scala |
| \u{X} | \u{1F600} | C++23, Rust, Swift, JavaScript, PHP, Ruby, Dart, Lua |
| \U00XXXXXX | \U0001F600 | C, C++, Objective-C, C#, Go, Python, R |
| \x{X} | \x{1F600} | Perl |
| \X | \1F600 | CSS |
| &#xX; | 😀 | HTML, XML |
| %uXXXX | %uD83D%uDE00 | - |
| U+XXXX | U+1F600 | - |
| 0xX | 0x1F600 | - |
| \N{name} | \N{GRINNING FACE} | C++23, Python, Perl |
В форматах \uXXXX и %uXXXX не-BMP символы представлены двумя кодовыми единицами в виде суррогатных пар UTF-16. В других форматах символ представлен одной кодовой точкой.
PHP
Язык php может использовать разные версии Unicode, узнать свою версию можно с помощью так:
echo IntlChar::getUnicodeVersion();Разработчики языка сделали доброе дело - создали имена (сценарии) языковым последовательностям, например вот так можно удалить из текста все, что обычно не используется в сообщениях русского человека:
echo preg_replace('/[^\p{Cyrillic}\p{Common}\p{Latin}]+/u', '', $string);Как видно, в тексте должны остаться только Кирилица, Латиница и Общие символы (кавычки, скобки и т.п.).
Комментарии
Комментариев пока нет.